
La tentación es evidente: coger una lista de design systems, puntuarlos del cero al cien y publicar quién va primero.
No lo vamos a hacer. Todavía no.
Antes de comparar sistemas hay que construir el instrumento que permite compararlos sin engañarse. Por eso esta pieza no es un ranking. Es una línea base: diez sistemas públicos, más la arquitectura que propone el propio Instituto, revisados contra documentación, repositorios y páginas oficiales a fecha de 14 de septiembre de 2026.
Una regla gobierna todo lo que sigue:
No observado no equivale a no existe.
Una organización puede tener una infraestructura excelente y no publicarla. Si no hemos encontrado evidencia pública, lo decimos así, con una marca propia (N/E, no especificado), y no lo convertimos en un suspenso.
Cuatro capas que conviene no mezclar
Un design system no determina la arquitectura completa del producto que lo usa. Que Primer distribuya componentes de React no dice cómo está construido GitHub.com por dentro. Que una organización tenga un servidor MCP de su design system no significa que sus interfaces las compongan agentes.
Para no confundir esas cosas, separamos cuatro capas independientes:
| Capa | Qué observamos | Ejemplo |
|---|---|---|
| Sistema | componentes, tokens, patrones, documentación | Primer, Carbon, Fluent |
| Contexto para agentes | MCP, skills, llms.txt, Markdown estructurado, instrucciones |
Atlassian, Primer, Spectrum |
| Validación | lint, tests, accesibilidad, schemas, evaluadores | Primer, Salesforce |
| Runtime de interfaz | cliente, remote rendering, UI dirigida por servidor, compositor | Shopify en ciertas extensiones; propuesta del Instituto |
Esa separación distingue dos preguntas que suelen mezclarse. La primera: ¿puede un agente comprender y usar correctamente el design system? La segunda: ¿puede un agente participar en la decisión o la composición de la interfaz en tiempo de ejecución? Un sistema puede estar muy avanzado en la primera sin que su documentación pública diga nada de la segunda.
Qué significa aquí «preparado para agentes»
No usamos una puntuación numérica inventada. La clasificación es cualitativa y mide evidencia pública observable, no la calidad del design system.
| Nivel | Evidencia exigida |
|---|---|
| Muy alta | interfaz específica para agentes, fuentes estructuradas, integración con código o componentes y mecanismos de validación |
| Alta | MCP, skills, llms.txt u otra interfaz para agentes suficientemente documentada, aunque algunas validaciones o integraciones sean limitadas |
| Media | tokens, documentación o código muy estructurados y versionados, pero sin interfaz pública para agentes localizada |
| Baja | documentación principalmente humana y pocos artefactos estructurados observables |
| N/E | evidencia pública insuficiente |
| Conceptual | arquitectura descrita, pero sin implementación pública demostrada |
Diez sistemas, una fotografía
Lo que sigue es lo que se puede comprobar hoy en las fuentes oficiales de cada sistema. La última columna es nuestra clasificación con la escala anterior: una lectura de evidencia pública, no una valoración de sus equipos.
| Sistema | Lo que muestra su evidencia pública | Preparación pública |
|---|---|---|
| Atlassian Design System | Servidor MCP, skills para agentes y un DESIGN.md generado desde la misma pipeline de contenido estructurado que alimenta el MCP y las skills |
Muy alta |
| GitHub Primer | Servidor MCP con 19 herramientas; en su repositorio, pruebas de regresión visual y de verificación de accesibilidad con Playwright, ADR y un paquete MCP propio | Muy alta |
| Salesforce LWC y SLDS | Herramientas DX MCP para LWC (beta), con un conjunto de validación que puntúa componentes en accesibilidad y seguridad; desde agosto de 2026, sustituidas por skills de LWC | Muy alta |
| Shopify | AI Toolkit que valida GraphQL, Liquid y extensiones contra sus schemas; los componentes de las extensiones de Admin se construyen con remote-dom |
Muy alta en su ecosistema de desarrollo |
| React Spectrum | llms.txt, versión Markdown de cada página y un servidor MCP |
Alta a muy alta |
| IBM Carbon | Carbon MCP en public preview; librerías de componentes en React y Web Components | Alta |
| GOV.UK Design System | GOV.UK Frontend con Nunjucks y Sass; no hemos localizado una interfaz específica para agentes | Media · interfaz para agentes N/E |
| U.S. Web Design System | componentes, patrones, tokens y utilidades; interfaz para agentes N/E | Media · interfaz para agentes N/E |
| Microsoft Fluent 2 | librerías para React, Web Components, iOS, Android y Windows; interfaz para agentes N/E en las fuentes revisadas | Media · interfaz para agentes N/E |
| Google Material 3 | el repositorio oficial de Material Web figura in maintenance mode pending new maintainers; MCP específico N/E | Media · interfaz para agentes N/E |
| Propuesta del Instituto | arquitectura de UI dirigida por servidor, con BFF, orquestación, compositor, validador y renderer en cliente, descrita como metodología en desarrollo | Muy alta conceptual · implementación N/E |
La última fila merece una aclaración, y conviene hacerla antes que nadie. La metodología pública que la describe está marcada como en desarrollo. No asumimos que institutoagentico.com funcione internamente con esa arquitectura, y no hemos publicado todavía un repositorio de referencia con schemas, validador y evaluaciones que permita comprobarla. Por eso su implementación aparece como N/E, aunque la ambición conceptual sea alta.
No hay dos bandos: hay una escalera
La comparación sugiere algo más útil que dividir los sistemas entre «tradicionales» y «dirigidos por servidor»: aparece una escalera de capacidades.
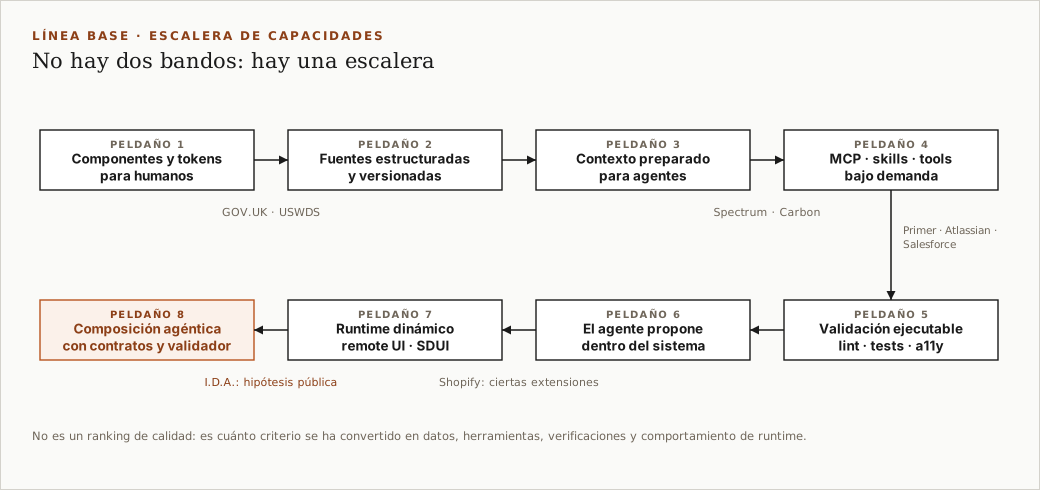
La lámina no es un ranking de calidad. Es un continuo conceptual: cuánto criterio se ha convertido en datos, herramientas, verificaciones y, al final, comportamiento en tiempo de ejecución. Muchos sistemas no necesitan subir todos los peldaños.
Leer tu sistema no es comprobar que se ha usado bien
Aquí aparecen diferencias más interesantes que «tiene MCP» o «no tiene MCP».
El servidor MCP de Primer no se limita a buscar documentación. Expone herramientas para listar componentes y consultar su API, obtener ejemplos, leer pautas de uso y de accesibilidad, buscar tokens por intención o por valor (find_tokens), revisar CSS contra el uso de tokens (lint_css) y evaluar textos alternativos de imágenes (review_alt_text).
Esa última parte cambia la categoría del sistema:
Un agente que puede leer tu design system no es lo mismo que un agente que puede comprobar si lo ha usado bien.
Salesforce lleva la idea un paso más allá. Su conjunto de validación para LWC puntúa la preparación de un componente para producción en accesibilidad, seguridad y otras buenas prácticas. Y su documentación indica que, desde agosto de 2026, las herramientas MCP para LWC quedan sustituidas por skills.
Ese movimiento es revelador. Lo interesante no es MCP en sí. Es convertir conocimiento implícito de una plataforma en capacidades que un agente puede invocar y verificar.
Lo que enseña Atlassian con su DESIGN.md
Atlassian ofrece la evidencia pública más útil sobre cómo distribuir contexto a un agente. En junio de 2026 publicó lo que aprendió al generar su propio DESIGN.md, un fichero Markdown estático que resume su sistema, y compararlo con otras vías.
Probó cuatro configuraciones (sin contexto, su servidor MCP, su skill y el DESIGN.md) y midió tokens, tiempo y turnos. Estos son sus datos:
| DESIGN.md | MCP | |
|---|---|---|
| Tokens de media | 7,21 millones | 3,75 millones |
| Tiempo medio | 6 min 46 s | 5 min 1 s |
| Turnos de media | 45,3 | 35,1 |
| Guía disponible | 80 KB | unos 2,5 MB bajo demanda |
| Contexto del sistema que aporta | alrededor del 30 % | alrededor del 80 % |
El DESIGN.md consumió un 92 % más de tokens que el MCP, con una variabilidad 2,7 veces mayor entre ejecuciones. En prototipado sirvió para que la interfaz generada dejara de ser genérica y se reconociera como Atlassian; en un entorno de producción con librerías de componentes existentes, funcionó peor. El propio fichero deja fuera las librerías de código, los linters y las especificaciones detalladas de Figma: recoge intención, no la especificación técnica completa.
Y hay una advertencia que conviene citar tal cual: «These results should not be seen as conclusive; this blog is not a research paper.» Son pruebas internas, no una investigación.
La conclusión que se puede defender no es «DESIGN.md no funciona». Es otra:
La documentación para agentes necesita arquitectura de información, recuperación y validación. No basta con hacerla legible para un modelo.
Seis verbos, y el derecho a pararse en el cuarto
Cuando un agente entra en un sistema, conviene separar qué puede hacer realmente.
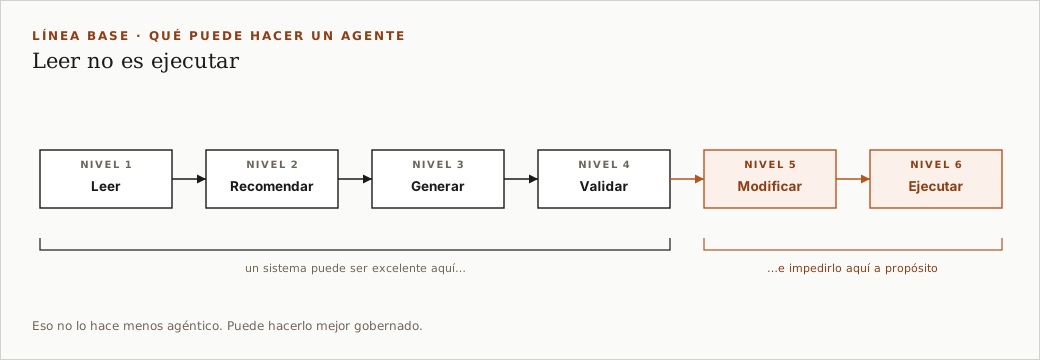
Un sistema puede ser excelente leyendo, recomendando, generando y validando, y aun así impedir deliberadamente que el agente modifique o ejecute.
Eso no lo hace menos agéntico. Puede hacerlo mejor gobernado.
Shopify ilustra esa frontera: su AI Toolkit permite al agente preparar y lanzar tareas de gestión de una tienda a través del contexto autenticado de su CLI, pero con la persona eligiendo cuándo ejecutarlas.
Cuánta libertad tiene quien compone la interfaz
Las extensiones de Admin de Shopify usan componentes nativos que siguen su design system y se construyen con remote-dom, su librería para interfaces multiplataforma. No conviene llamar a eso «UI dirigida por servidor» sin matices. Pero apunta a una idea muy relacionada con la que defiende el Instituto: quien produce la experiencia no necesita libertad arbitraria sobre la interfaz para producir una interfaz dinámica. Basta con exponer piezas y contratos.
Ese patrón merece una dimensión propia:
| Grado de libertad | Modelo |
|---|---|
| Cerrado | pantallas y componentes definidos a mano |
| Configurable | plantillas y propiedades |
| Componible | combinaciones restringidas por un schema |
| Remoto | productor remoto, renderer controlado |
| Dirigido por servidor | el servidor decide la estructura |
| Compuesto por agente | el agente participa en decisiones de composición |
| Ejecutado por agente | el agente además puede ejecutar acciones |
No todos los productos necesitan llegar al último escalón.
Mover la decisión al servidor no elimina la complejidad: la mueve
La arquitectura que propone la metodología del Instituto coloca en el dispositivo piezas conocidas y un renderer. En el servidor viven el BFF, la orquestación y el compositor. El servidor no envía la pantalla: envía una descripción estructurada, y un validador interviene antes de entregarla.
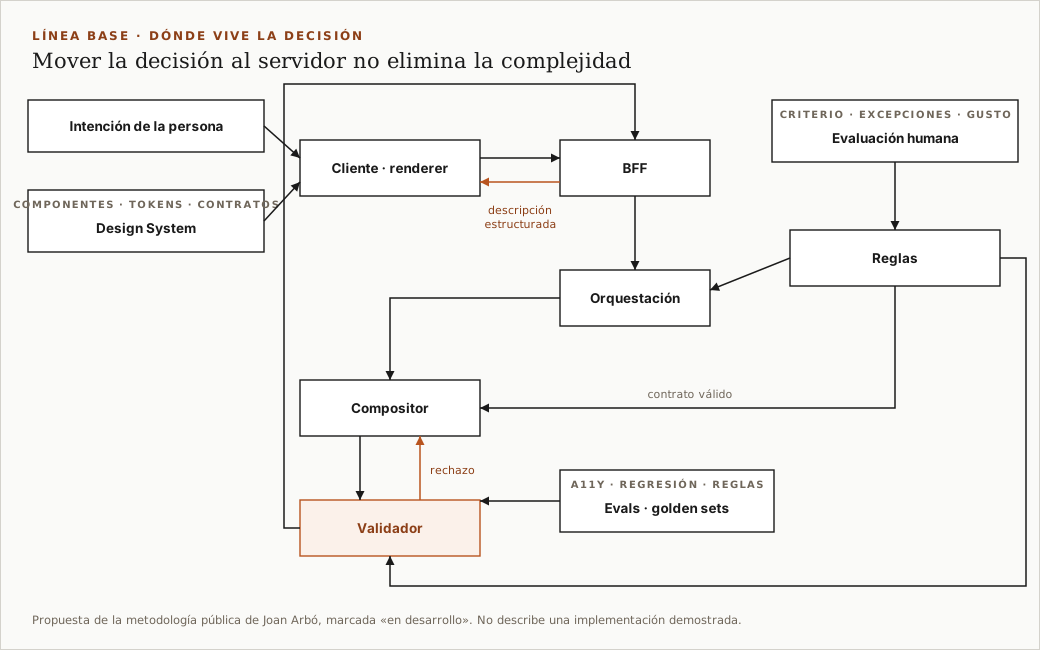
Sobre el papel, eso permite cambiar ciertas decisiones de composición sin publicar una nueva versión del cliente. Pero aparecen al menos cinco costes:
- Versionado del contrato. Cliente y servidor tienen que compartir qué componentes, propiedades, estados y versiones son válidos.
- Compatibilidad hacia atrás. Un servidor capaz de producir un elemento que un cliente antiguo no reconoce puede romper la experiencia.
- Observabilidad. Si cada composición depende de contexto, reglas y resultados de agentes, hay que poder reconstruir por qué apareció una experiencia concreta.
- Validación. Una composición sintácticamente válida puede seguir siendo una mala experiencia.
- Autorización. Que un agente pueda proponer una acción no significa que pueda ejecutarla. La metodología establece que los permisos se aplican en servidor y no dependen de que el modelo recuerde una regla.
Ese último punto coincide con la especificación de MCP del 28 de julio de 2026. Pide tratar las herramientas con la cautela que merece una ejecución arbitraria de código y exige consentimiento explícito antes de invocarlas. Para las herramientas, los servidores deben validar todas las entradas, controlar el acceso, limitar las invocaciones y sanear las salidas; los clientes deberían pedir confirmación en operaciones sensibles, validar los resultados antes de pasarlos al modelo y registrar el uso para poder auditarlo.
La misma intención, cinco implementaciones
Fluent 2 mantiene librerías para React, Web Components, iOS, Android y Windows. Carbon ofrece librerías en React y Web Components, y ahora un MCP. Ese tipo de sistema permite una pregunta de evaluación mucho mejor que «¿tiene tokens?»:
¿La misma intención produce una decisión semánticamente equivalente en todas las implementaciones?
Para un agente, la divergencia semántica es especialmente peligrosa. Puede conocer bien el concepto Button y estar usando la guía de React para una implementación en iOS. La documentación puede ser perfectamente legible por máquinas y, aun así, estar sirviendo el contexto equivocado.
Un design system y su implementación viven ciclos distintos
Material Design 3 es el design system de código abierto de Google. Y, al mismo tiempo, su repositorio oficial de Material Web indica que está en modo mantenimiento a la espera de nuevos responsables.
Por eso una fila que diga «Material: activo» no sirve. Cualquier registro serio necesita separar, como mínimo:
Design language
Implementación
Plataforma
Versión
Estado de mantenimiento
Interfaz para agentes
Última verificación
Un registro así modela relaciones y estados, no una lista de nombres.
Componente accesible no es composición accesible
El GOV.UK Design System es un buen control. Su propia guía lo dice sin rodeos: «Using the GOV.UK Design System in a service does not immediately make that service accessible.» El servicio sigue necesitando trabajo adicional de investigación, diseño, desarrollo y pruebas, aunque use estilos, componentes y patrones accesibles.
La misma lógica vale para los agentes: un componente accesible no garantiza una composición generada accesible. La accesibilidad de un sistema agéntico debería desglosarse así:
Accesibilidad del componente
  + accesibilidad de la composición
  + accesibilidad de estados y transiciones
  + accesibilidad del contenido generado
  + regresión automática
Diez vulnerabilidades que conviene registrar
La entrada de agentes crea riesgos distintos a los de una biblioteca de componentes convencional. En enero de 2026, el CAISI del NIST abrió una solicitud de información sobre la seguridad de los sistemas de agentes que menciona, entre otros, ataques de inyección indirecta de instrucciones, envenenamiento de datos, objetivos mal especificados y vulnerabilidades de autenticación. Y el roadmap de MCP sigue trabajando en la identidad y la delegación de los agentes: esta capa todavía se mueve deprisa.
Para un design system agéntico, estas son las que merece la pena medir:
| Vulnerabilidad | Dónde aparece | Qué medir |
|---|---|---|
| Deriva de contexto | MCP, documentación, skills | ¿Código y contexto describen la misma versión? |
| Envenenamiento de instrucciones | agentes que leen documentación o repositorios externos | ¿Qué fuentes se consideran de confianza? |
| Herramientas con privilegios de más | MCP con escritura o ejecución | ¿Se aplica el principio de mínimo privilegio? |
| Inyección indirecta de instrucciones | agentes que consumen contenido externo | ¿Los datos pueden alterar las instrucciones? |
| Escape del contrato | UI remota o dirigida por servidor | ¿Puede generarse un componente o propiedad no permitidos? |
| Desajuste entre autorización e interfaz | cualquier UI dinámica | ¿Ocultar una acción sustituye por error a la autorización en servidor? |
| Fallo de accesibilidad en la composición | UI generada | ¿Se prueba la pantalla resultante y no solo las piezas? |
| Uso semántico incorrecto de tokens | todos | ¿El token existe, pero se usa con otra intención? |
| Guía caducada | llms.txt y Markdown estático |
¿La documentación corresponde al paquete instalado? |
| Componente alucinado | agente sin fuentes suficientes | ¿Se rechazan APIs y componentes inexistentes? |
Y una más, transversal: la decisión no trazable. ¿Puede reconstruirse por qué se eligió un resultado?
Una definición para no confundirnos
De todo lo anterior sale una definición que preferimos a cualquier puntuación:
Un design system está preparado para agentes cuando hace posible que un agente lo comprenda, proponga, lo utilice y, cuando corresponda, lo ejecute dentro de límites que puedan inspeccionarse y verificarse.
No es el sistema que mejor genera interfaces. Es el que mejor deja comprobar lo que un agente ha hecho con él.
Cómo se mide sin engañarse
Ausente y desconocido no son lo mismo
Imagina dos sistemas. En el primero, la documentación oficial dice explícitamente que no hay pruebas de accesibilidad. En el segundo, simplemente no has encontrado documentación sobre pruebas.
No pueden recibir la misma nota. Cualquier registro necesita, como mínimo, estos estados:
YES
NO
PARTIAL
NOT_APPLICABLE
NOT_SPECIFIED
NOT_PUBLIC
STALE
Una nota sin su cobertura no significa nada
Cada evaluación debería publicarse con dos cifras: la preparación y la cobertura de evidencia. Un ejemplo ilustrativo, no un dato real: un sistema con 78 sobre 100 y un 94 % de cobertura no significa lo mismo que otro con 78 sobre 100 y un 31 % de cobertura. El segundo número dice cuánto de esa nota se apoya en algo comprobado.
Tres niveles de evidencia
Un directorio y un benchmark se diferencian aquí:
- Auditoría de evidencia. Inspeccionar documentación, repositorios y artefactos públicos.
- Verificación estática. Comprobar automáticamente la presencia y la estructura de tokens, paquetes, schemas, tests, instrucciones para agentes, documentación y changelog.
- Evaluación con agentes. Ejecutar tareas controladas y reproducibles contra el sistema.
El tercer nivel es el que de verdad dice algo. Todavía no lo hemos ejecutado, así que no publicamos resultados. Este es el protocolo que proponemos:
| Prueba | Tarea |
|---|---|
| Descubrimiento de componentes | dada una intención, localizar el componente o patrón correcto |
| Intención del token | elegir un token semántico correcto sin usar un valor en bruto |
| Selección de patrón | distinguir entre dos componentes plausibles |
| Conciencia de restricciones | detectar cuándo no usar un componente |
| Formulario accesible | producir una implementación que supere los tests públicos disponibles |
| Fidelidad a la API | no inventar propiedades ni componentes |
| Corrección de reglas | recibir un error del validador y corregirse |
| Eficiencia de contexto | medir el contexto necesario para llegar a la solución |
| Fidelidad de versión | usar la guía compatible con la versión instalada |
| Gestión de lo desconocido | abstenerse o pedir contexto cuando no hay evidencia suficiente |
Para que los datos sean reproducibles hay que registrar el modelo y su versión, la fecha, el prompt, las instrucciones de sistema, la fuente de contexto, las herramientas disponibles, las llamadas a herramientas, la versión del paquete, los tokens consumidos, la latencia, los errores, el resultado de los tests, cualquier intervención humana y el artefacto resultante.
Solo entonces se puede decir algo que valga la pena. No «Primer tiene un 93 sobre 100», sino: con este modelo, esta versión, estas herramientas y este protocolo, el agente eligió correctamente X de Y patrones, y todas las ejecuciones son reproducibles.
Es la misma cautela que aplica Atlassian a sus propias cifras. No publicaríamos «el MCP es un 92 % mejor». Publicaríamos: bajo tal protocolo observamos tal resultado, y repetiremos la prueba en la siguiente edición.
Lo que esta línea base no demuestra
No demuestra que ningún sistema sea mejor que otro. Clasifica evidencia pública, y la ausencia de evidencia pública no es un veredicto sobre el trabajo de ningún equipo.
No demuestra tampoco que la arquitectura que propone el Instituto funcione mejor. Hoy es una propuesta conceptual con implementación pública no evaluable, y así figura en la tabla.
Lo que sí deja es un instrumento: cuatro capas separadas, una escala de evidencia que distingue lo ausente de lo desconocido, una lista de vulnerabilidades y un protocolo de pruebas con agentes que todavía hay que ejecutar. Crecer en número de sistemas solo tiene sentido si cada ficha nueva mantiene ese rigor. Preferimos pocos sistemas bien verificados a cientos revisados por encima.
El objetivo no es demostrar que el Instituto tenía razón. Es tener un mecanismo para descubrir dónde la tenía, dónde no y qué está cambiando de verdad en el oficio.
Las ocho dimensiones del diagnóstico del Instituto (sistema, reglas, tokens, documentación, gobierno, agentes, accesibilidad y evaluación) son el punto de partida de esta rúbrica. Si quieres mirar tu propio sistema con esta misma disciplina, empieza por ahí.
Nota de verificación editorial
Revisión realizada el 14 de septiembre de 2026 a partir de un informe de investigación preparado con ayuda de IA y contrastado, dato a dato, con las fuentes primarias enlazadas al pie. Las cifras de Atlassian proceden de su artículo del 15 de junio de 2026 y son pruebas internas, no una investigación. La clasificación de preparación pública es cualitativa y propia de esta línea base: mide evidencia observable, no calidad. Se han excluido deliberadamente las estimaciones de dificultad, mantenimiento y tamaño de equipo de cada organización, porque no son datos publicados por ellas. No se citan afirmaciones que no pudieron verificarse en la fuente original. La evaluación con agentes descrita es un protocolo propuesto; ninguna de sus pruebas se ha ejecutado todavía.
Fuentes
- 01 Atlassian · Atlassian’s DESIGN.md is herewww.atlassian.com/blog/how-we-build/atlassians-design-md-is-here-what-we-learned-testing-portable-design-context-in-practice →
- 02 Primer · MCP serverprimer.style/product/getting-started/foundations/mcp →
- 03 primer/react · copilot-instructions.mdgithub.com/primer/react/blob/main/.github/copilot-instructions.md →
- 04 IBM Carbon · Carbon MCP (Public Preview)carbondesignsystem.com/developing/carbon-mcp/overview →
- 05 React Spectrum · AIreact-spectrum.adobe.com/ai →
- 06 Shopify · AI Toolkitshopify.dev/docs/apps/build/ai-toolkit →
- 07 Shopify · Admin UI extensionsshopify.dev/docs/api/admin-extensions →
- 08 Salesforce · DX MCP Tools for LWCdeveloper.salesforce.com/docs/platform/lwc/guide/mcp-intro.html →
- 09 GOV.UK Design System · Accesibilidaddesign-system.service.gov.uk/accessibility →
- 10 GOV.UK Frontendfrontend.design-system.service.gov.uk →
- 11 U.S. Web Design Systemdesignsystem.digital.gov →
- 12 Fluent 2 · Developfluent2.microsoft.design/get-started/develop →
- 13 Material Web · GitHubgithub.com/material-components/material-web →
- 14 Model Context Protocol · Especificación 2026-07-28modelcontextprotocol.io/specification/2026-07-28 →
- 15 Model Context Protocol · Toolsmodelcontextprotocol.io/specification/2026-07-28/server/tools →
- 16 Model Context Protocol · Roadmapmodelcontextprotocol.io/development/roadmap →
- 17 NIST CAISI · Solicitud de información sobre la seguridad de agenteswww.nist.gov/news-events/news/2026/01/caisi-issues-request-information-about-securing-ai-agent-systems →
- 18 Joan Arbó · Metodología: diseñar mediante reglasjoanarbo.com/metodologia →
- 19 Instituto de Diseño Agéntico · Diagnósticowww.institutoagentico.com/diagnostico →
A seguir
Redactado con ayuda de IA, contrastado contra su fuente y firmado por Joan Arbó.
Del diario al fondo de armario
- GuíaFigma MCP para design systems: el circuito diseño-código sin handoffQué expone el servidor MCP de Figma, cómo lo consume un agente como Claude Code o Cursor, y qué tiene que tener tu design system para que el circuito funcione de verdad.
- GlosarioAI-readiness de un design systemHasta qué punto un design system está preparado para que lo use una IA por su cuenta: con los valores de diseño (tokens) en un formato estándar, la documentación escrita de forma que una máquina pueda leerla, las reglas dichas de forma explícita y una vía de conexión (un servidor MCP) para que el agente lo consulte.
- GuíaCómo se implementa un MCP server para tu design systemAnatomía mínima de un servidor Model Context Protocol que expone los tokens, principios y componentes de tu sistema a un cliente agéntico.