
Llevo tiempo defendiendo una frase bastante rotunda:
Las reglas deciden; el modelo explica.
La frase funciona porque establece una frontera. A un lado, una regla que se puede leer, discutir y comprobar. Al otro, un modelo probabilístico que redacta, resume y encuentra relaciones, pero que no debería tener la última palabra sobre una decisión importante.
La Vigencia parecía el proyecto adecuado para demostrarlo.
Cada día recoge publicaciones oficiales, las convierte en piezas legibles y calcula un índice de impacto regulatorio. La fórmula está escrita en código. Sus cinco pesos suman uno. Si recibe las mismas entradas, devuelve el mismo resultado. No hay aleatoriedad en el cálculo.
Hasta aquí, la tesis se sostiene.
Entonces dejé de mirar la fórmula y seguí el rastro de sus entradas.
Ahí apareció el problema.
La fórmula era determinista. El juicio que la alimentaba, no del todo.
En el snapshot que revisé, el índice combina cinco ejes:
- rango normativo: 20 %;
- alcance: 18 %;
- coste de cumplimiento: 27 %;
- urgencia: 20 %;
- densidad regulatoria: 15 %.
El cálculo final es explícito. También hay pruebas que comprueban que los pesos suman uno y que una misma entrada produce una misma salida.
Pero tres partes del cálculo pueden recibir campos producidos por el modelo:
- el alcance usa los sectores y colectivos afectados que el modelo ha identificado;
- el coste usa como proxy principal una valoración de impacto del modelo, de 1 a 5;
- la urgencia prefiere una fecha límite extraída por el modelo cuando existe.
El eje con más peso (coste, un 27 %) puede arrancar precisamente de llm_impact.
Esto no convierte el índice en aleatorio. Tampoco significa que el resultado sea inútil. Significa algo más incómodo y más preciso: la fórmula es determinista respecto a unas entradas que no son completamente deterministas.
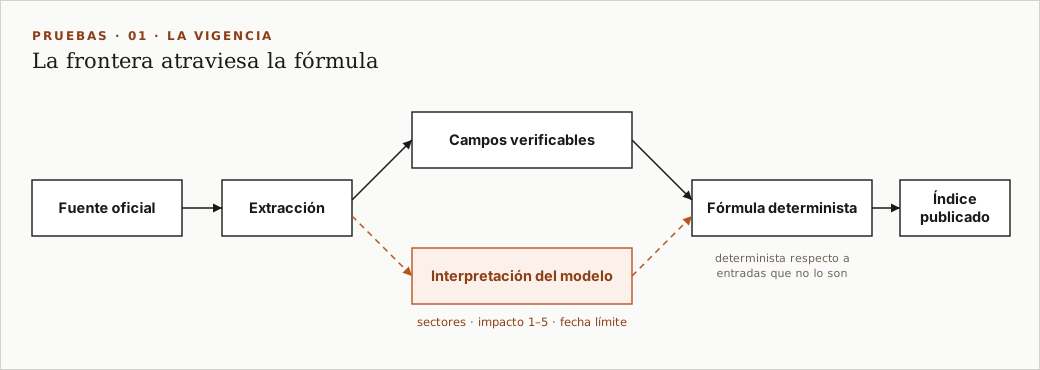
Yo había dibujado una frontera entre regla y modelo. El código me enseñó que, en esta versión, la frontera atraviesa la fórmula.
Lo importante no es ocultarlo. Es convertirlo en la siguiente prueba.
La reacción fácil sería cambiar la frase. Hacerla más blanda hasta que nada pueda refutarla: “las reglas ayudan a decidir”, “el modelo participa”, “hay una combinación híbrida”.
No me interesa.
Prefiero conservar la tesis fuerte y elevar el nivel de la implementación.
Para que “las reglas deciden” sea literalmente cierto, cada entrada que cambia el índice debería pertenecer a una de estas tres categorías:
- Dato de la fuente. El rango de la norma, la fecha publicada, el organismo, una fecha de entrada en vigor que aparece en el documento.
- Transformación verificable. Una operación explícita sobre esos datos: días hasta la fecha, número de sectores dentro de un catálogo cerrado, presencia de una sanción respaldada por un artículo concreto.
- Juicio humano registrado. Cuando no existe una regla suficiente, alguien asume la decisión, deja el criterio y firma la excepción.
El modelo puede proponer una fecha, localizar un pasaje o sugerir a quién afecta. Lo que no debería hacer es introducir silenciosamente el valor que mueve la clasificación.
La diferencia está en una palabra: proponer.
La prueba que falta
La revisión del código demuestra la dependencia. No demuestra todavía cuánto altera el resultado.
Para saberlo hay que hacer una ablación: ejecutar el mismo archivo de normas de dos maneras.
| Ejecución | Entradas interpretativas | Pregunta |
|---|---|---|
| A | Con llm_impact, sectores y fecha extraídos por el modelo |
¿Cuál es el ranking actual? |
| B | Sin esos campos; solo datos oficiales y reglas derivadas | ¿Cuánto cambia el ranking? |
| C | Con revisión humana ciega sobre los casos que cambian | ¿Qué versión se acerca más al criterio editorial? |
No voy a inventar el resultado de esa comparación. Hoy no lo tengo.
Lo que sí tengo es un criterio para leerla:
- si casi nada cambia, el modelo estaba acelerando la extracción, no gobernando la decisión;
- si cambian muchas posiciones, la promesa pública es más fuerte que el sistema real;
- si solo cambian los casos ambiguos, necesitamos una parada humana explícita, no un promedio más sofisticado.
Ese experimento vale más que otro texto sobre “IA responsable”. Produce una medida, una discrepancia y una decisión de diseño.
“Pero una persona también interpreta”
Sí. Ningún índice serio elimina el criterio.
Publicar una fórmula no vuelve objetiva una decisión editorial. Elegir los cinco ejes, asignarles pesos y decidir qué cuenta como coste ya son decisiones humanas. La alternativa no es un sistema sin juicio; es un sistema que sabe dónde está su juicio.
La diferencia es que una decisión humana puede quedar vinculada a una versión, una evidencia y una persona responsable. Una inferencia del modelo también puede registrarse, pero no debería disfrazarse de dato porque haya terminado dentro de una función matemática.
Una fórmula visible puede producir una falsa sensación de auditabilidad. Podemos revisar la multiplicación y, aun así, no saber quién decidió el número que se multiplicó.
Lo que esta prueba cambia en mi tesis
No retiro “las reglas deciden; el modelo explica”. La vuelvo más exigente.
Ahora añadiría:
Una decisión no se vuelve reglada por ocurrir dentro de una fórmula. También hay que gobernar el origen de sus entradas.
La unidad mínima de una decisión auditable no es el resultado. Es la cadena completa:
fuente → extracción → transformación → regla → resultado → revisión.
La Vigencia ya conserva una parte importante de esa cadena: fuentes oficiales, fechas, validadores y una fórmula legible. La prueba ha encontrado el siguiente tramo que hay que construir.
Eso es exactamente lo que quiero que hagan estos proyectos. No ilustrar una teoría que ya está terminada, sino encontrar el punto donde deja de ser cierta.
Cierre
Durante años hemos presentado los casos de diseño como relatos sin fricción. Había un problema, aplicamos un proceso y apareció una solución. Todo lo que no encajaba se eliminaba antes de publicar.
Con sistemas agénticos, ese formato sirve de poco. Lo que necesitamos ver es dónde entró el juicio, qué regla falló y qué parte todavía no podemos delegar.
Abrí La Vigencia buscando una demostración.
Encontré una corrección.
Es mejor material.
Si estás diseñando un sistema donde un modelo propone y una regla decide, en el Instituto de Diseño Agéntico trabajamos precisamente esa frontera: no cómo escribir un prompt más convincente, sino cómo convertir criterio en contratos que se puedan inspeccionar y poner a prueba.
Nota de verificación editorial
Revisión realizada sobre el repositorio local de La Vigencia, revisión 91bdea7, el 14 de septiembre de 2026. Archivos principales: src/lib/regpulse-scoring.ts, src/agents/writer.ts y tests/unit/scoring.test.ts. Esta prueba confirma la arquitectura y la dependencia de entradas; no mide todavía su efecto sobre un conjunto histórico. La ablación descrita es el siguiente experimento, no un resultado ya obtenido.
Fuentes
- 01 Expediente A.03 · La Vigenciawww.institutoagentico.com/casos/lavigencia →
A seguir
Redactado con ayuda de IA, contrastado contra su fuente y firmado por Joan Arbó.